目次
1. 結論:Argonを試すなら、何度も前提を説明し直していた仕事から
2026年10月22日時点の公式情報を確認した比較記事です。 本稿は各モデルを同条件で実測したランキングではない。仕様・料金・提供元の位置づけを土台に、実務でどのモデルから試すかを提案する。
新しいAIが出るたびに、「結局、全部これに乗り換えればいいのか」と迷う。けれど、メールを一通整える仕事と、仕様書・動画・既存コードを照合して改修する仕事では、必要な能力がかなり違う。料理でいえば、毎朝のトーストに、大人数の宴会を仕切る厨房を使う必要はない。
Gemini 4 Argonは、材料が多く、考える工程が長く、成果物も大きい仕事で試したいモデルだ。 Googleは複雑なソフトウェア開発、数学・科学、複数段階のエージェント作業を主な用途に挙げる。まずは「途中で背景を忘れた」「出力が切れた」「動画を別途文字起こしして渡していた」という仕事を一つ持ってくると、特徴を評価しやすい。[3]
一方、日常の修正・下書き・資料作成にはGPT-6.1 SolやClaude Sonnet 5.5、判断の難しい開発や調査にはGPT-6 AstraやClaude Opus 5.5も有力な比較候補となる。ここでの推奨は、各社の公表した用途から組み立てた試す順番であり、個々の仕事での勝敗を保証するものではない。[7][11][10]
自分なら、いま使っているモデルを残したまま、Argonに同じ難題を一件渡す。「すごい回答が出たか」より、完成までの手直しが減ったかを比べたい。成果物を使う人にとっては、途中の流暢さより、最後に使える状態で届くことの方が大きい。
2. 何が新しいのか:長い入力に加えて、長い思考と出力を扱う
Argonの発表は2026年9月30日。当初の案内はFairwind Programを通じた信頼されたサイバー防御担当者への提供が中心だった。その後、10月13日のGoogle Cloud発表ではAPI、AI Studio、Antigravityなどへの提供が案内されている。発表直後の「まだ一般には使えない」という記事と、現在の提供案内は日付を分けて読む必要がある。[1][2]
仕様で押さえたいのは、1,048,576トークンの枠を、入力・思考・出力が共有することだ。トークンはモデルが文章などを処理する単位であり、日本語の文字数やPDFのページ数と一対一には対応しない。入力だけで100万トークンを使い、その外側にさらに100万トークンを書けるわけではない。[4]
たとえるなら、大きな作業机の上に、資料と作業中のメモと完成原稿を一緒に置く。資料を机いっぱいに広げると、書き上げるための場所は減る。容量が大きいことと、何をどれだけ載せるかを考えなくてよいことは別だ。
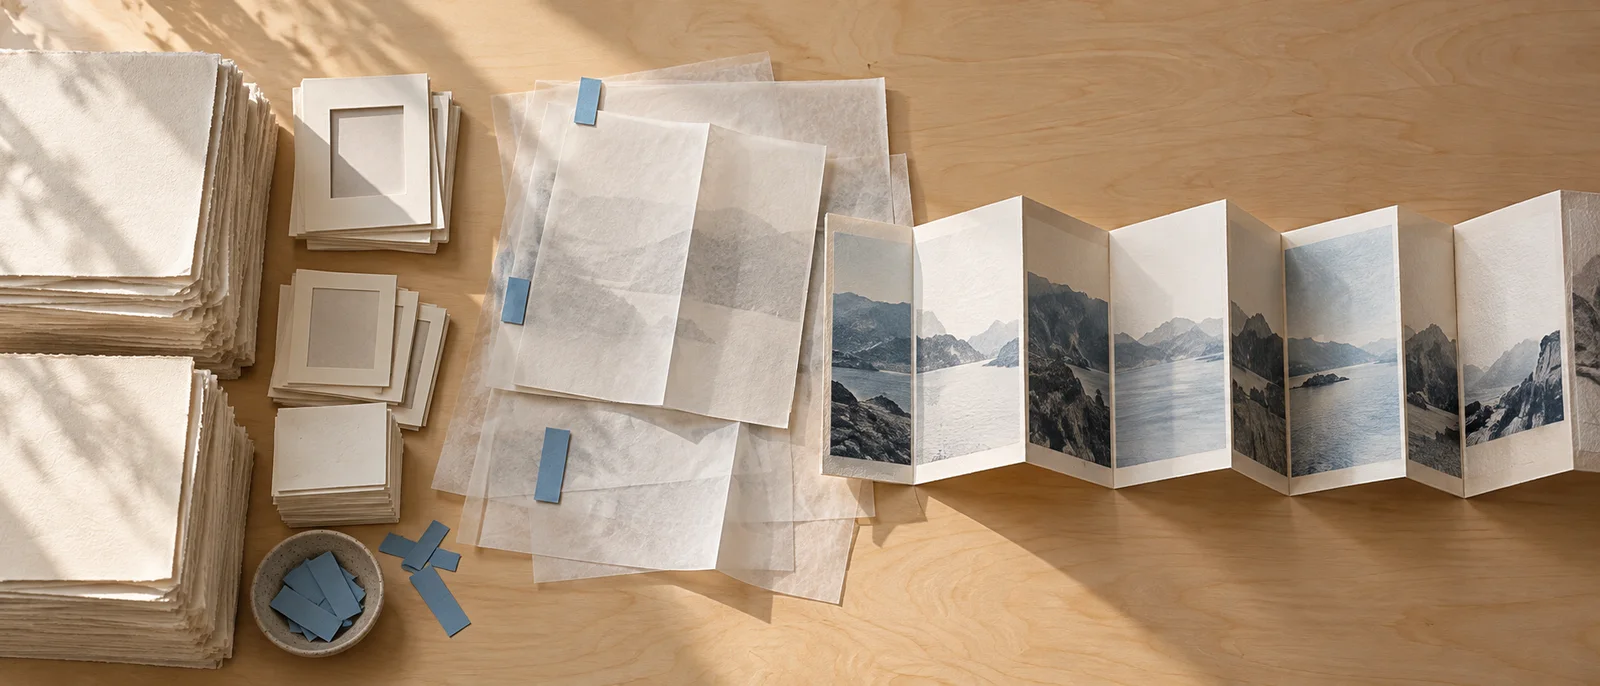
同じ机を資料・作業・成果物で分け合う。Argonの100万トークンは、入力専用の容量ではない。
通常の同期処理では最大出力は65,536トークン。これを超える長い生成にはbackground executionを使い、最大約100万トークンまで、入力などが使った分を差し引いた範囲で出力する。内部では最大64Kトークンの単位で継続し、完了時には複数の出力ステップを扱う。つまり「一回の普通のチャットで長大な本が必ず出る」という仕様ではなく、長時間ジョブとして管理する機能だ。[5]
ここから先は運用上の考察になる。大きな成果物を扱えても、修正しやすい単位へ分ける価値は残る。章ごとにレビューできる報告書や、テスト可能な変更単位で納品するコードなら、途中の誤りを早く見つけられる。長文出力の余裕は、分割をすべて廃止する理由ではなく、出力上限のためだけに作業を不自然に切らずに済む余地と考えるとよい。
もう一つの特徴は、テキスト・画像・動画・音声・PDFを入力できること。出力はテキストで、Argon自体に画像生成や音声生成はない。録画を理解させることと、完成した動画を生成させることは、使う機能が異なる。[3]
3. 主要モデルとの違い:会社名より、仕事の大きさと入口を見る
今回の比較の中心は、一般的な開発・知識労働で導入を検討しやすい次のモデルだ。全世界のモデルを網羅した表ではなく、Argonを試すときに一緒に並べたい候補を選んだ。
| モデル | 公表された位置づけ | 最初に比較したい仕事 |
|---|---|---|
| Gemini 4 Argon | 複雑な推論、長い工程、長文出力。動画・音声も直接入力 | 録画・仕様・コードを照合する改修、大量資料からの長い成果物 |
| GPT-6.1 Sol | 高度な仕事の性能と費用のバランス | 開発、調査、資料作成を幅広く回す日常の主力 |
| GPT-6 Astra | OpenAIの最も難しい仕事向けの旗艦 | 調査や設計で、誤った判断の手直しが高くつく案件 |
| Claude Opus 5.5 | 複雑で、継続した判断が必要な仕事 | 要件が曖昧な改修、複数の制約が衝突する設計 |
| Claude Sonnet 5.5 | 範囲が明確な日常業務、修正、文書などの作成 | バグ修正、資料の整形、短い反復で仕上げる作業 |
左二列は公式資料の要約、右列はそこから導いた本稿の提案である。[3][8][9][10][11]
GPT-6系との違いは「長い資料を読めるか」だけではない。 SolとAstraもコンテキストは1,050,000トークンあり、長い文脈自体はArgonだけの専売特許ではない。一方、両モデルの最大出力は128,000トークン。比較したいのは文脈の名目サイズより、必要な出力量、入力形式、ツールを含む仕事の完成度だ。[8][9]
ClaudeはOpusとSonnetを分けて見る。 Anthropicは、Sonnetが得意な範囲の明確な業務と、Opusが強い継続的な判断を要する仕事を区別している。したがって「Claudeは文章、Geminiは検索」と会社単位で性格を固定してしまうと、同じ会社の中にある役割の差を見落とす。[11]
また、モデルそのものと、それを使うアプリを分けたい。同じモデル名でも、参照できるファイル、ブラウザ、検索、権限、実行時間、利用上限が違えば、任せられる仕事は変わる。APIのコンテキスト上限を、そのまま消費者向けチャットの添付上限や一日の利用回数として読むことはできない。
短い反復と、大きな仕事の継続では、欲しい道具が違う。モデルと作業環境を一組で選ぶ。
同社内の選択肢も忘れたくない。Googleには速度と費用効率を掲げるGemini 3.8 Flashがあり、こちらも動画・音声・PDF入力に対応する。OpenAIには大量処理向けのGPT-6 Luna、Anthropicには10月7日公開のClaude Haiku 5.5がある。要約や分類を大量に回すために、すべてを上位モデルへ送る必要はない。[13][7][12]
発売順を見ると、Opus 5.5が9月22日、Sonnet 5.5が9月28日、Argonの発表が9月30日、Haiku 5.5が10月7日。新しく出たモデルが、すべての価格帯を置き換えるわけではない。重い仕事と軽い仕事に異なる選択肢が増えた、と読む方が実用的だ。[10][11][1][12]
4. 料金の比較:Argonは12月から比較相手が変わる
次は標準APIのテキストトークン単価、100万トークン当たりの米ドル。キャッシュのない入力と、課金対象の出力を比較する。サブスクリプションの月額料金ではない。[6][8][9][10][11]
| モデル・期間 | 入力 | 出力 |
|---|---|---|
| Argon:2026年11月30日まで | $2 | $10 |
| Argon:2026年12月1日から | $4 | $20 |
| GPT-6.1 Sol | $2 | $10 |
| GPT-6 Astra | $10 | $50 |
| Claude Opus 5.5 | $4 | $20 |
| Claude Sonnet 5.5 | $2 | $10 |
Argonの導入価格はSol・Sonnetと同じ、通常価格はOpusと同じ。 「安いからArgon」という判断には、いつまでの料金かを添える必要がある。Googleの料金表では思考トークンも出力課金に含まれる。見えている回答の長さだけでは、請求を予測できない。[6]
試算してみよう。1件当たり、未キャッシュ入力5万トークン、課金対象の出力1万トークンを使うと仮定する。モデル間で同じトークン数になるという実測ではなく、単価差だけを見る計算だ。100件なら、Argonの導入価格・Sol・Sonnetは各20ドル、Argonの通常価格・Opusは各40ドル、Astraは100ドルとなる。式は「入力数÷100万×入力単価+出力数÷100万×出力単価」。
この試算には、追加の思考による超過、再試行、検索等のツール利用、キャッシュ作成・読み出し、税、為替、保存や実行環境の料金を含めない。実際にはモデルごとにトークンの区切り方も、完了までに必要な量も違う。さらにSol・Astraは入力が272Kを超えるリクエストで、入力・キャッシュ料金が2倍、出力料金が1.5倍になる。長い資料を渡す用途では、基本単価だけの比較が特に危ない。[8][9]
逆に、同じ資料を繰り返し使うならキャッシュの影響が大きい。Argonは暗黙的キャッシュに対応し、ヒットした入力は95%引きになる。ただし明示的キャッシュには対応しない。毎回の全入力が割引される前提で予算を組むのではなく、実際の利用記録を確認したい。[4]
最終的に見る指標は、使える成果物1件当たりの総費用だ。安いモデルで5回やり直すより、高いモデルで一度で終える方が安いこともある。その逆もある。API費用に加え、人が修正した時間を記録すると、「単価は安いのに使うと疲れる」という違いまで見えてくる。
5. 具体的な使い分け:三つの仕事で試す順番を決める
録画と既存仕様を照合し、改修案を作る
画面操作の録画、仕様のPDF、関連するコードを渡し、「録画のどの場面が仕様と違うか」「修正候補はどこか」「どう検証するか」をまとめる。このように入力の種類が混ざる仕事は、Argonを試す理由が明確だ。Googleのモデル仕様では動画と音声を直接入力できる。[3]
ただし、録画を渡すだけで正しい原因へ到達するとは限らない。出力には時刻、根拠ファイル、未確定事項を付けてもらう。録画で見えた症状と、コードから推測した原因を別欄にすると、もっともらしい原因の作り話を検出しやすい。音声や画面の抽出方法が違う競合と比べる場合は、その前処理にかかった時間も評価に含める。
大きなコード変更を、設計から検証まで進める
API変更が複数の画面やテストに波及する案件なら、Argon、Opus、Astraを候補にする。ここで比べたいのはコードの文字数ではなく、依存関係を追い、既存の挙動を守り、変更を検証できるかだ。途中で解釈が分かれたら、その理由を記録するように頼む。
一方、「この関数の境界条件を直す」「文言を置き換える」のように範囲を閉じられるなら、SolやSonnetから始める。上位モデルへの切り替えは、同じ説明を繰り返しても原因を掴めない、変更範囲が予想以上に広い、といった具体的な失敗が出てからでよい。これは公式な性能順位ではなく、評価費用を抑えるための運用案である。
多数の資料から、会議で使う判断材料を作る
議事録と仕様と見積もりから、選択肢、根拠、未決事項をまとめる仕事では、Argonの長い文脈を試せる。ただ、資料が多いほど優れた回答になるとは限らない。旧版と最新版を混ぜれば、容量に余裕があっても矛盾の原因になる。文書名と更新日を付け、優先する版を指定することが先だ。
最終成果物が数ページなら、長大な出力能力を使い切る必要はない。SolやSonnetでも要件を満たせるか比べる。逆に、長い仕様書と付録を整合させながら生成するなら、Argonのlong decodeを試す意味がある。どちらでも、根拠のない断定と、資料に書かれた事実を分けて納品させたい。
録画、仕様、実装をつなぐ仕事は、入力形式の違いが作業量に効く。結論だけでなく、どの資料を根拠にしたかも受け取る。
6. ベンチマークの読み方:「1位」より、仕事に近い条件を探す
提供元のベンチマークは有益だが、そのまま自分の仕事の成功率にはならない。例えばAnthropicは、Sonnet 5.5のTerminal-Bench 4.0を70.6%と報告している。これは特定の評価セットと実行条件の結果であり、「普段の開発の70.6%を自動で完了する」という意味ではない。[11]
点数を比べる前に、モデルの正確な版、推論の強さ、ツールの有無、試行回数、評価セットの版を揃える。Terminal-Benchの別バージョン同士や、ツールあり・なしの点数を並べて順位を付けても、モデルだけの差は取り出せない。提供元が示す競合の点数は、いつのどの設定で測ったかも見る。
特に「考える強さ」を変えられるモデルでは、同じ名前が同じ費用や待ち時間を意味しない。Argonにはlow・medium・highがあり、既定はmedium。まず既定で試し、難しい案件だけhighも比較する方が、すべてを最大設定で使うより違いを判断しやすい。[4]
本稿では、条件を揃えた横断実測を行っていないため、Argonと全競合の勝率表は作らない。公開仕様で差が明確な部分と、自分の仕事で測る必要がある部分を分ける。その境界を守った方が、「新しいから優秀」「一つの問題で失敗したから使えない」という両極端を避けられる。
7. 導入でつまずくところ:APIの差し替えと長時間処理
既存のGemini連携をArgonへ変える開発者は、モデル名だけを置き換えて終わりにしない。公式移行ガイドでは、sampling用のtemperature・top_p・top_kは指定しても無視され、明示的キャッシュは非対応とされる。また、思考と回答が出力上限を共有するため、小さな上限を引き継ぐと回答が途中で終わり得る。[4]
利用者向けに言えば、「いつもの細かな設定が同じように効くとは限らない」ということだ。管理画面に設定項目が見えていても、対象モデルで有効かは別に確認する。低いtemperatureだから必ず同じ文章になる、といった運用前提は持ち込まない。
長い生成を組み込む場合は、開始、処理中、完了、失敗、キャンセルを扱う。待っている間に利用者が再度ボタンを押したら、二重の仕事と費用が発生するかもしれない。ジョブIDを保存し、同じ仕事を再開できる設計が必要になる。long decodeの出力も、最初のテキストだけを読んで全体が完成したと扱わない。[5]
導入の順番としては、まず読み取り専用で成果物の質を確かめ、次にコピーした作業環境で変更を試すのが扱いやすい。メール送信、公開、削除のように外部へ影響する操作は、成果物の生成とは分けて権限を決める。モデルが賢くなっても、古い資料や曖昧な依頼から誤った作業を実行する可能性まで消えるわけではない。
8. 今日試すなら:普段の三つの仕事を、完成まで比べる
大規模な評価基盤を作る前に、普段の仕事から短い修正、複数資料の照合、難しい設計の三件を選んでみよう。三件は統計的な優劣を証明するサンプル数ではない。自分に関係する差が出るかを見る、小さな試運転だ。
各候補へ、同じ入力と次の依頼を渡す。ツールの違いを揃えられない場合は、アプリを含めた比較として記録する。
この資料を使い、指定した成果物を完成させてください。根拠のある事実と推測を分け、未解決事項を残してください。変更した点と確認した方法を示し、外部への送信・公開・削除は行わないでください。途中で前提が矛盾したら、その箇所を示してください。
採点項目は、①重要な誤り、②根拠の追いやすさ、③完成までの時間、④人間の手直し時間、⑤実際の費用。どれを優先するかも先に決める。数値の誤りが許されない集計なら速さより正確さ、何度も試す文章案なら修正のしやすさを重くする。
評価の終点は、最初の回答が届いた時ではなく、人が使える成果物になった時。
Argonで手直しが減る仕事が見つかれば、その仕事の担当にする。短い業務で違いが出なければ、使い慣れたSolやSonnet、軽量モデルを残す。重い設計で別のモデルの方がよければ、そこだけ役割を渡す。モデル選びを、一度きりの乗り換えではなく、仕事ごとの小さな配属として考えると続けやすい。
Gemini 4 Argonを試す価値は、長い入力、長い思考、長い出力、多様な資料を一つの作業へまとめられるかにある。まず一件、これまで説明のやり直しが多かった仕事を渡してみる。その結果と実際の費用が、次に使うモデルを決める材料になる。
確認範囲について: 料金と仕様は2026年10月22日時点。地域、契約、アプリ、API、段階的な提供で利用条件は変わる。導入時にはリンク先の現行仕様と自分のアカウントでの提供状況を確認してほしい。本稿の仕事例・試算・評価手順は筆者の提案であり、各社の性能保証ではない。
参考文献・出典
- [1]Google, Introducing Gemini 4 Argon(2026-09-30). ↩
- [2]Google Cloud, Gemini 4 Argon available on Google Cloud(2026-10-13). ↩
- [3]Google AI for Developers, Gemini 4 Argon model specifications. ↩
- [4]Google AI for Developers, What's new in Gemini 4 Argon(2026-10-16更新). ↩
- [5]Google AI for Developers, Long decode. ↩
- [6]Google AI for Developers, Gemini Developer API pricing. ↩
- [7]OpenAI, Models. ↩
- [8]OpenAI, GPT-6.1 Sol Model. ↩
- [9]OpenAI, GPT-6 Astra Model. ↩
- [10]Anthropic, Introducing Claude Opus 5.5(2026-09-22). ↩
- [11]Anthropic, Introducing Claude Sonnet 5.5(2026-09-28). ↩
- [12]Anthropic, Introducing Claude Haiku 5.5(2026-10-07). ↩
- [13]Google AI for Developers, Gemini 3.8 Flash. ↩
NOVEL SERIES VOL.1
世界が少し遠くなった
世界を変えない。けれど、距離は少し変わる。
約束を軽く扱えない男と、出会ってしまった人たちの物語。続編『曇りグラス』も公開中。読むなら、まずはここから。
Amazonで覗いてみる
自叙伝ドットコム
あなたの人生は書く価値がある。
AIにだから語れる、本当の自分がある。記憶の断片を拾い集め、ひとつの物語へ。
覗いてみる関連記事
2026年10月前半のAIニュース10選|Gemini 4 Argon、GPT-6.1 Sol、Claude Haiku 5.5、Metaの816Bオープンモデルまで
2026年10月1日〜19日のAIニュースから、使う人・作る人・働く人に関係の大きい10本を選び、何が起きたか・何が変わるかを一次情報と報道で確かめて整理した。新モデル3社の値段、エージェントの広がり、安全性の報告、EUのAI法、声優の声のルールまで。
AIエージェントは「グレーなコード」をどこまで拒否するのか
OpenAI・Google・Anthropicのポリシーと実運用の差を踏まえ、SNS自動化のようなグレー領域でAIエージェントがどこで拒否し、どこで補助してしまうのかを整理します。
シルバーウィーク、AIの勢力図が変わった──GPT-6 Astra・Sol・LunaとClaude Fable・Opus・Sonnetを徹底比較
Astra先行からSol・Luna登場へ。Fable 5.1に迫るOpus 5.5、同価格のSolとSonnet 5まで6モデルを比較。発売順、精度、実費、キャッシュ、利用条件から2026年9月のAI競争を読み解く。
AIにも国境が引かれた日|「知能」は輸出管理されるのか
Claude Fable 5とClaude Mythos 5の停止を起点に、AIモデルの重み、輸出管理、サイバー防衛、技術主権、そして「危険な知恵」を誰が管理するのかを考える長編考察です。
OpenAI「コードレッド」の真相──GeminiとClaudeに追い上げられた巨人の次の一手
OpenAIが「コードレッド」を宣言した背景を、ベンチマーク逆転、エンタープライズ市場シェア、巨額インフラ投資、安全性リスクの4軸で整理し、次の一手をエンジニア視点で読み解きます。
ぽちょ研究所の実験