目次
0. 前提:Jevとは何か
- TypeSafeはサービス(提供元)の名前で、Jevはそこが提供する「System One」と呼ばれる系統のモデルの名前。APIでは「jev-latest」のように指定して呼ぶ。[4]
- 普通のLLMとの一番の違いは、文章を生成しないこと。返ってくるのは、こちらが決めた型の判定と確率だけだ。[2]
- 質問の型は三つある。
- Noul:はい/いいえの判定。true/falseではなく、「はい」である確率(0〜1)で返る。例:「この問い合わせは緊急か」→ 0.95
- Choice:こちらが定義した選択肢から一つを選ぶ。全選択肢の確率と確信度も一緒に返る。選択肢は1問で最大255個まで持てる。例:「この語はどの分野の用語か」
- Score:こちらが文章で定義した段階(最大10段階)のどこに当たるかを、1.43のような小数で返す。例:「どれくらい現役の技術か」
- リクエストは、判定の材料(state)と質問の一覧(questions)を1回送るだけ。互いに独立した質問なら、まとめて送れば並列に答えてくれる。[3]
- 料金は入力トークンだけにかかり、出力は無料。[4]
LLMでも同じ判定はできる。ただ、プロンプトに選択肢を並べて文章で答えさせ、その文章を解析し、確からしさを知りたければ同じ質問を何度か投げて答えがそろうかを見る──という手順になりがちだ。生成する文章と往復が増えるぶん、時間も費用もかさむ。Jevは、その「判定だけが欲しい」場面に絞ったモデルだと考えると分かりやすい。
前提はここまで。ここから、実際に使ってみた話に入る。
1. 「安いらしい」を、遊んで分かる形にしたかった
社内で「Jev」が話題になっていた。「やばい、乗り遅れてる」と思って調べると、とにかく速くて安いらしい。でも、APIを一度叩いて数字を眺めるだけでは、何に使うと面白いのかがつかめない。
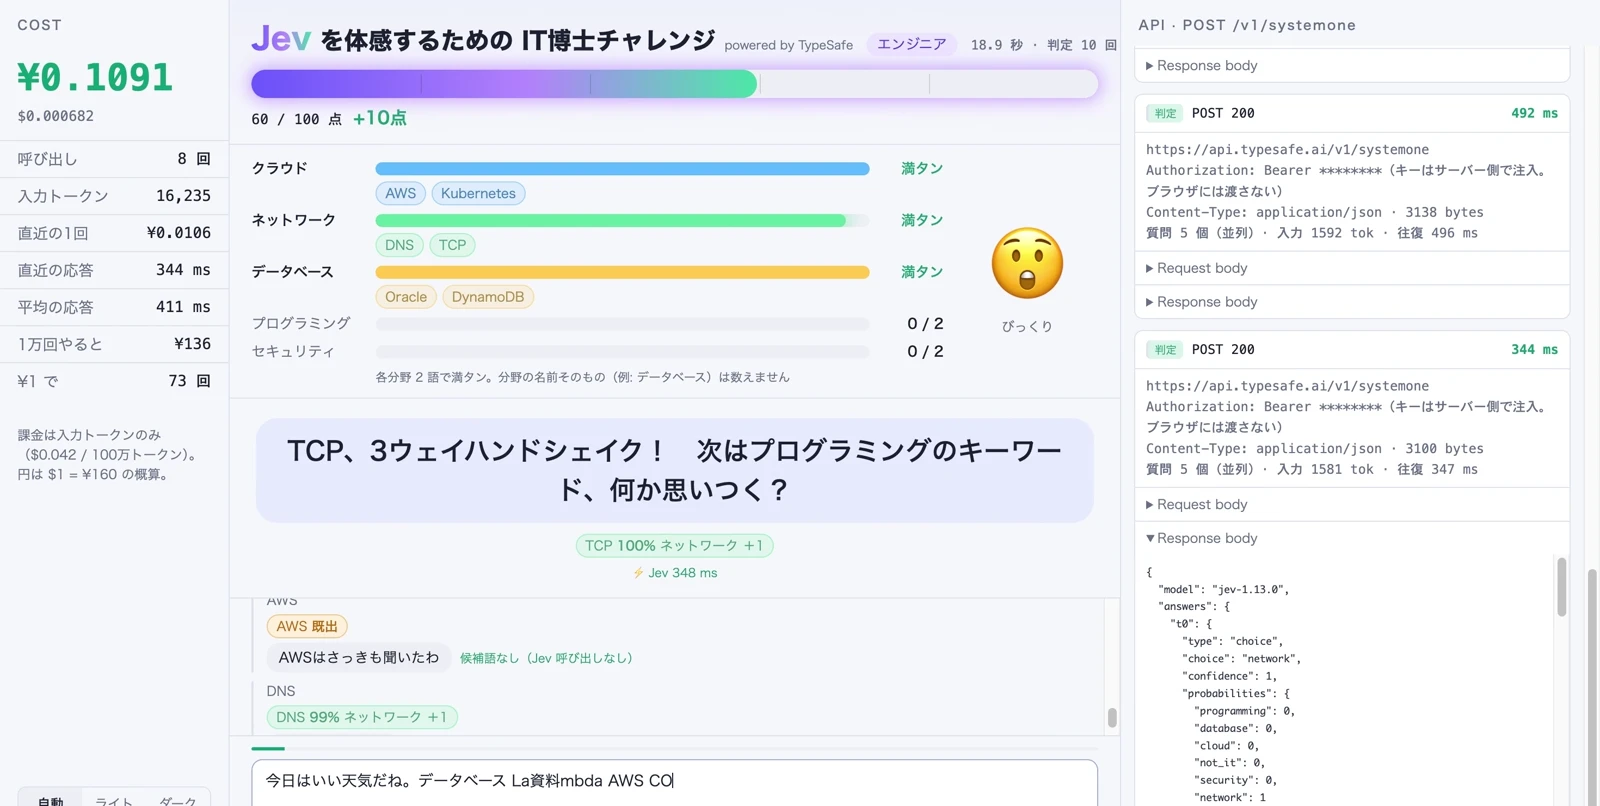
そこで最終的にできたのが、IT用語を入力して五つのメーターを埋める「IT博士チャレンジ」だ。送信ボタンはない。言葉を入れると判定が返り、その語が該当する分野へ飛んでいく。左には費用、右にはHTTPリクエストとレスポンス。速さと安さを、動く画面ごと見られるようにした。[1]
入力→判定→メーターへの移動を見てほしい。入力はデモモード(?demo)の自動再生で、人の打鍵を模して1文字ずつ入れている。APIの応答は実測、費用は実測トークン数からの換算。早送りなし、録画の先頭1秒のみカットした素材を使っている。
登録すれば$5の無料枠が付くという噂も聞いたが、私の登録では付かなかった。キー発行には課金が必要で、最低チャージが$5だったので、その分だけ入れた。これは私が利用したときの体験で、無料枠や最低額を今後の全ユーザーに保証する話ではない。
2. 最初は、アプリを作るつもりさえなかった
Claude Codeに頼んだのは「まず使えるようにして」。相談しているうちに、エージェントの方から、呼び出しの中身を見える化する小さなツールと確認用のページが出てきた。そこから「じゃあこんな感じで」「あんな感じで」と、ほぼ音声入力で方向を伝えていった。
最初の形は会話メーターだった。でも、一方的に話してメーターを伸ばすだけではつまらない。IT用語を集めるゲームへ寄せると、今度は返しの深掘り質問が流れを止めた。「もっと詳しく」と聞くより、次の用語を言いたくなる方がいい。録画用アイコンが残っていれば「ダサいから消そう」と直す。そういう判断を重ねた。
会話は合計2時間ほど。人間が書いたコードは0行。 ただし、人間が何もしなかったわけではない。「何を試したいか」「ここは面白いか」「これは変だ」を決め、できたものを見て方向を変える作業をしていた。
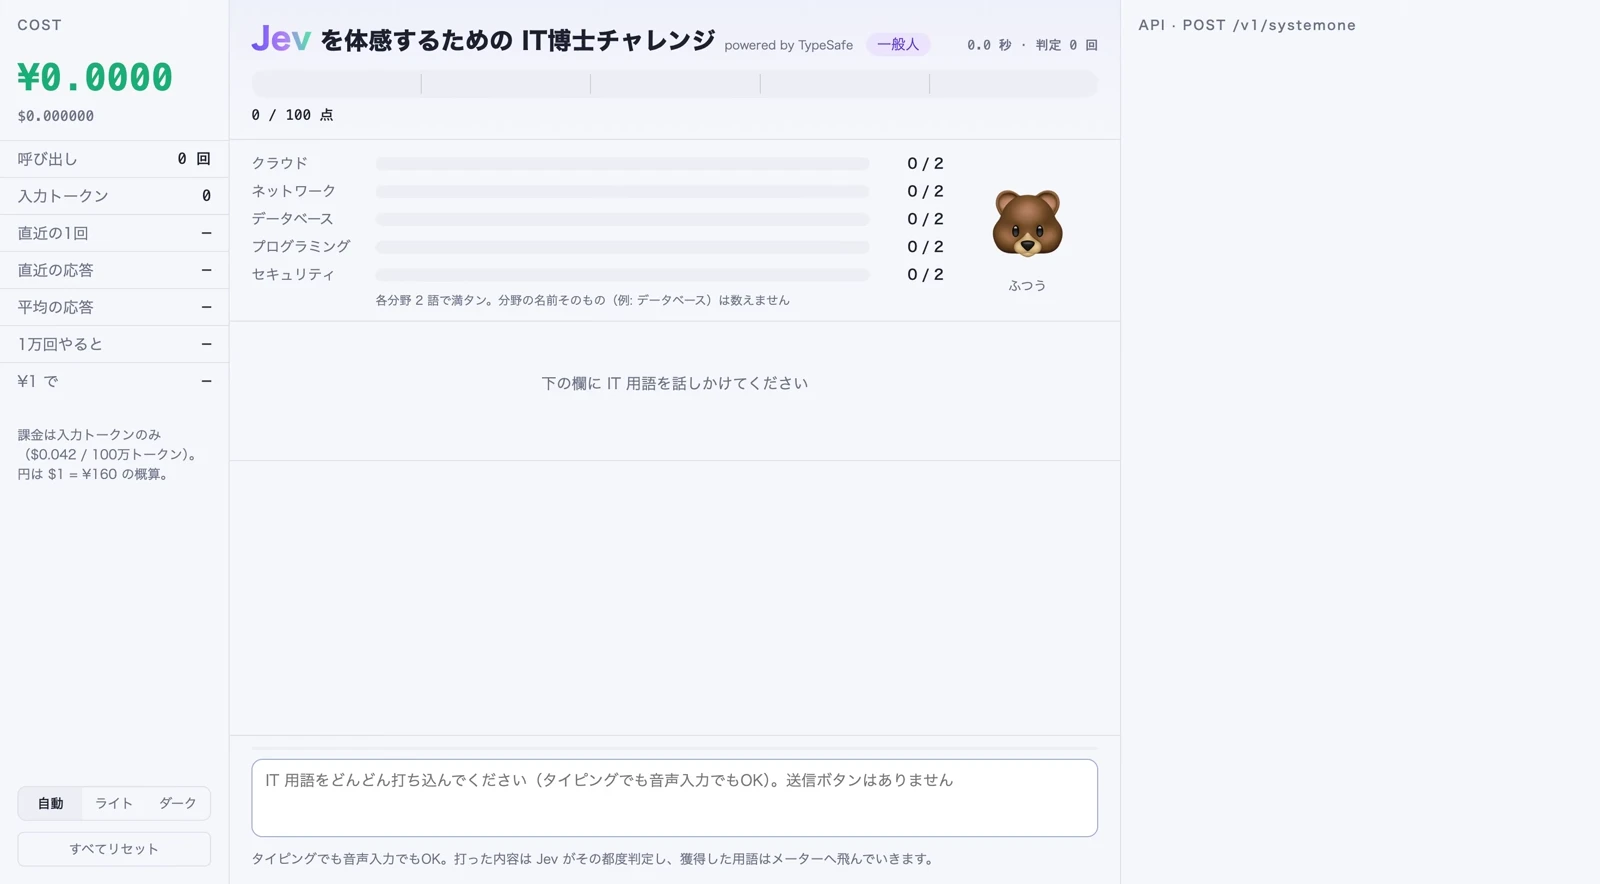
ルールは各分野2語、五つ全部でクリア。「データベース」のような分野名そのものは数えない。空のメーターを見ると、次に何を入れたいかが分かる。画像はクリックで拡大できる。
この小さな制作では、エージェントが実装を進めるほど、人間の仕事は方向性と試したいことの判断へ寄った。最初から完成図を持っていなくても、動くものへの違和感を言葉にできれば、次の形を試せる。その往復自体が面白かった。
3. Jevには判定を、コードには計算を任せる
0章で紹介したNoul・Choice・Scoreの三つの型を、今回のゲームはすべて使っている。[2]
返しをLLMに書かせる案もあったが、それでは文章生成の待ち時間が体感速度を左右する。今回はJevの速さを感じたかったので、ゲームの実行時はプログラム+Jevだけにした。開発に使ったClaude Codeとは役割が別だ。
- Jev:分野、現役度、学習コスト、通好み度、豆知識のどの技術名に当たるかを判定する。
- コード:入力を区切り、候補語を抽出し、点数を計算する。判定結果から返しを選び、既出の語を検出する。APIキーはローカルの中継サーバーが注入し、ブラウザには渡さない。
豆知識も「生成」ではなく「選択」だ。たとえばOracle用の一言をあらかじめ用意しておき、Jevには入力がどの技術名かを選ばせる。表記が「モラクル」のように崩れていても候補に当たることがあった。完全一致の辞書だけでは拾いにくい部分をJevに任せ、表示する文章はコードで管理する。
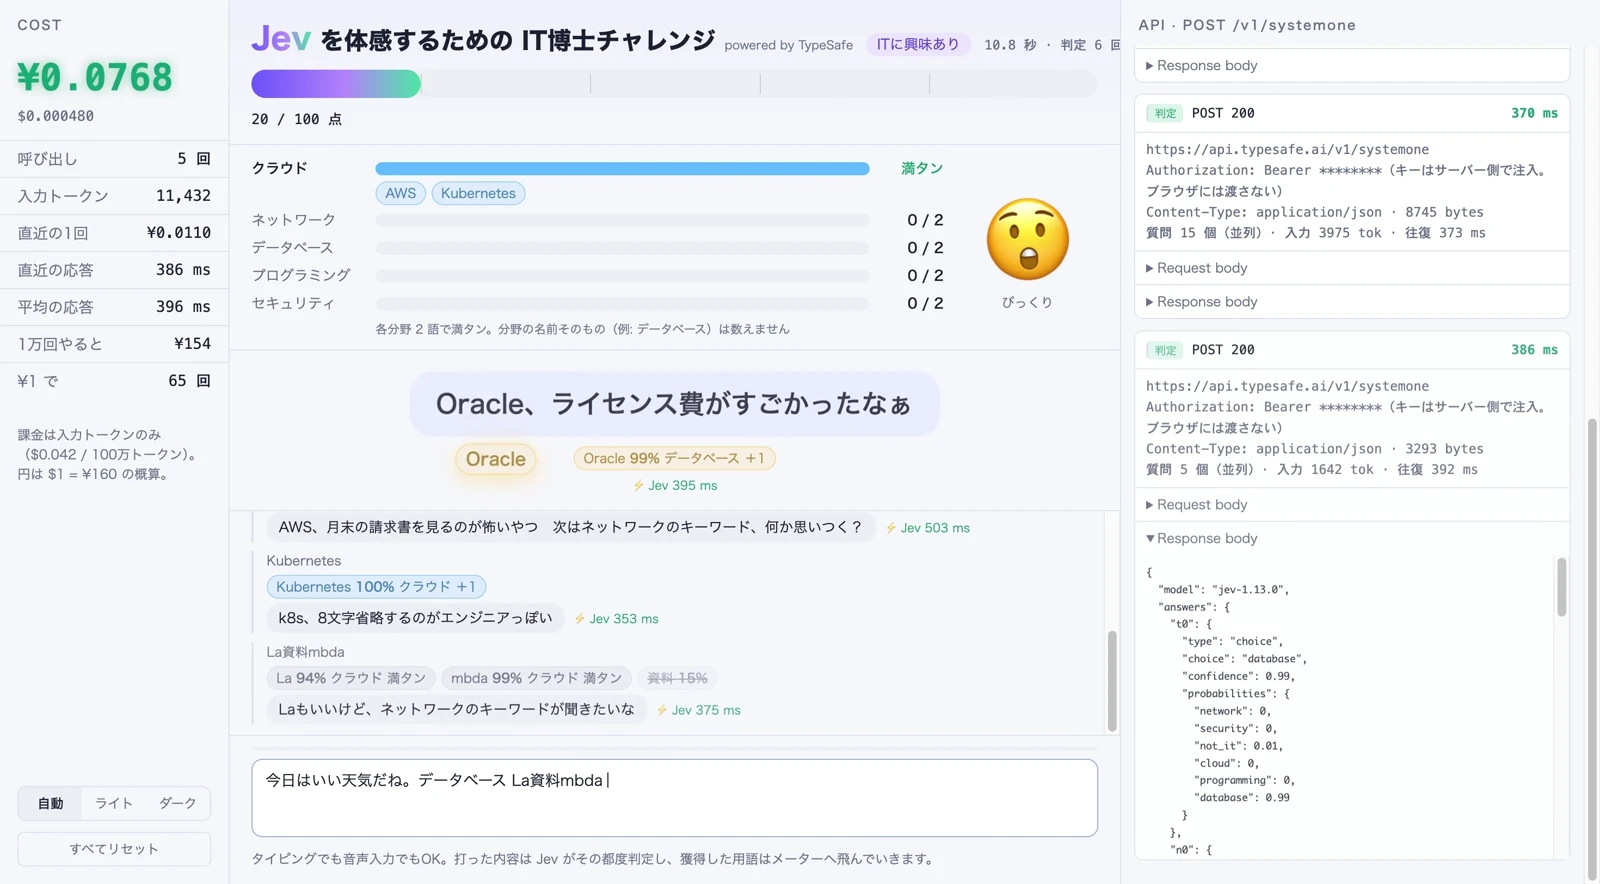
この一言をJevが書いたわけではない。技術名の照合結果を受けて、コードがOracle用の候補文を選んでいる。
4. 1語に5問。でもリクエストは1回
「Oracle」はどの分野か、どれくらい現役か、難しいか、通好みか、豆知識はどれか。これを順番に5回問い合わせず、同じstateに対する5問として一度に送る。公式も、同じstateを使う独立した質問をまとめて並列評価する設計を案内している。[3]
実装が送るJSONの構造は次のとおり。説明のため質問文と候補を短縮した抜粋で、そのまま実行するための設定ではない。
{
  "model": "jev-latest",
  "state": { "segment": "Oracle" },
  "questions": {
    "t0": { "type": "choice", "instructions": "Oracleの分野は?",
      "criteria": { "database": "データベース", "not_it": "IT用語ではない", "...": "他の分野" } },
    "n0": { "type": "score", "instructions": "通好み度は?", "criteria": ["有名", "普通", "通好み"] },
    "e0": { "type": "score", "instructions": "現役度は?", "criteria": ["過去", "古め", "定番", "新しい"] },
    "h0": { "type": "noul", "instructions": "学習コストが高い?" },
    "k0": { "type": "choice", "instructions": "その技術の名前そのものは?",
      "criteria": { "oracle": "Oracle Database", "none": "該当なし", "...": "他の技術名" } }
  }
}
READMEに記録したOracleの応答は386ms、入力1,642トークン。answersの一部を抜くと、長い説明文ではなく、そのままコードで使える値が返る。
{
  "t0": { "type": "choice", "choice": "database", "confidence": 0.99,
    "probabilities": { "database": 0.99, "not_it": 0.01 } },
  "e0": { "type": "score", "score": 1.52 },
  "h0": { "type": "noul", "noul": 0.55 },
  "k0": { "type": "choice", "choice": "oracle", "confidence": 0.92 }
}
残りの確率や回答は省略した。コードはこの結果から、データベースへ加点し、Oracle用の一言を出す。5問あっても約400msで戻ってくるため、入力から反応までが短く感じられる。なお、現役度や難しさはゲームの返しを選ぶ評価で、技術の採用率や習得時間を調査した数字ではない。
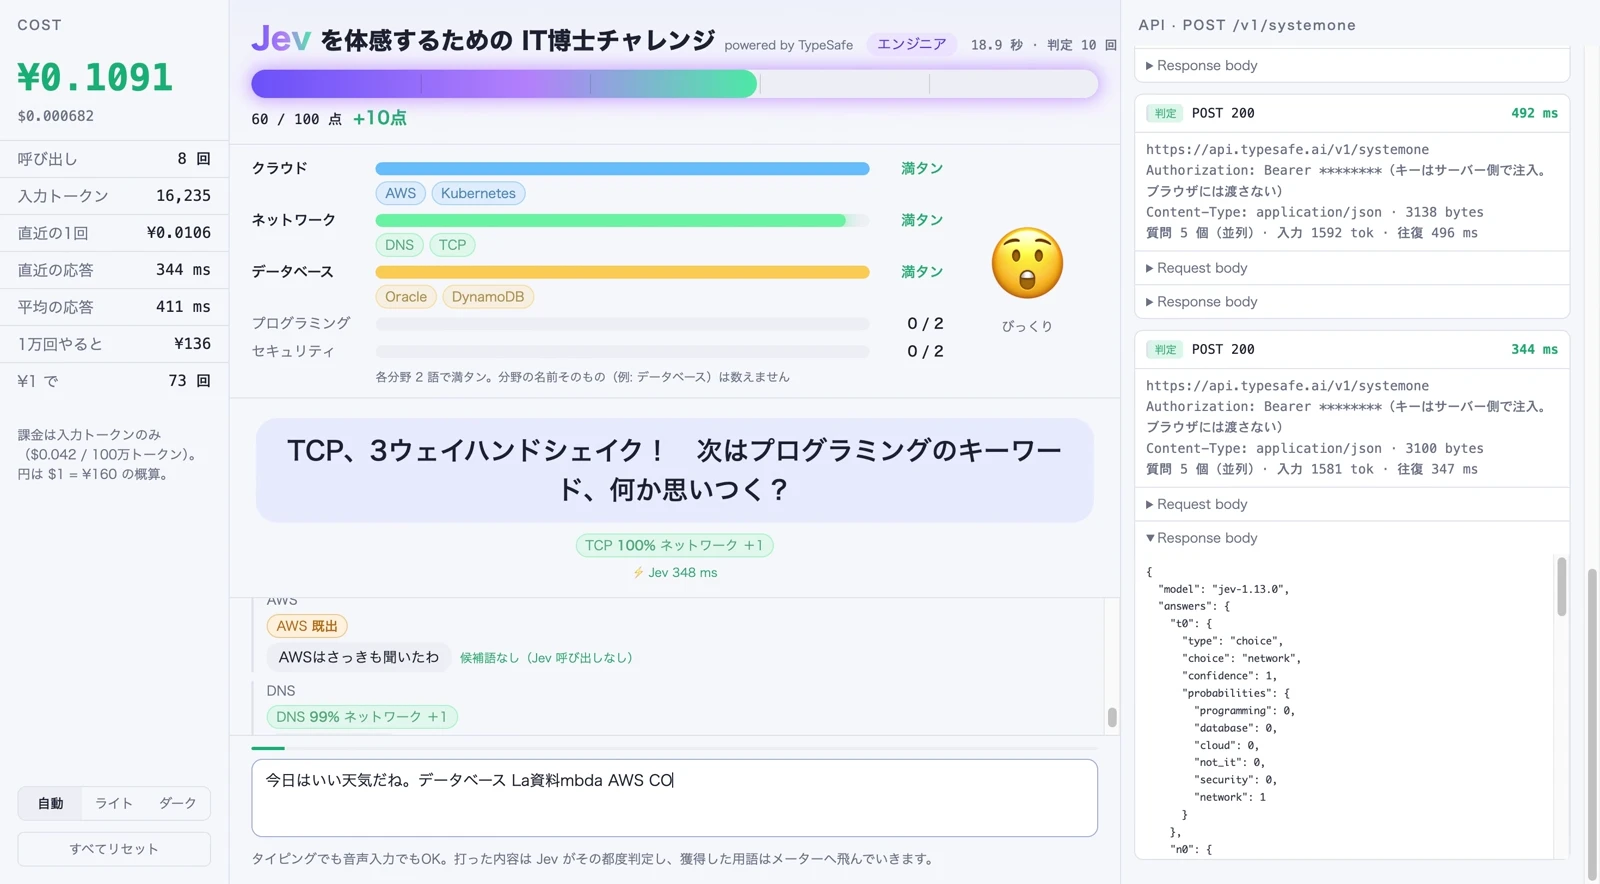
右のログで質問数と返った値、左で累積費用を追える。成功した演出だけでなく、その裏の呼び出しも同じ画面に出した。
5. 1回約0.15円、試行錯誤を全部含めても約5円
掲載動画のクリア画面は25.2秒、判定14回、平均407ms、¥0.1532。READMEには別のデモ記録として約¥0.14とあるが、この動画の表示では約¥0.15だった。判定14回にはコードだけで処理した入力も含まれ、実際のAPI呼び出しは12回だ。
平均msは、中継サーバーからTypeSafeへ送って応答を読み終えるまでの計測。文字を入力する時間や画面のアニメーションを全部含む値ではない。費用は応答の入力トークン数に単価を掛け、$1=¥160という固定の換算前提で表示している。
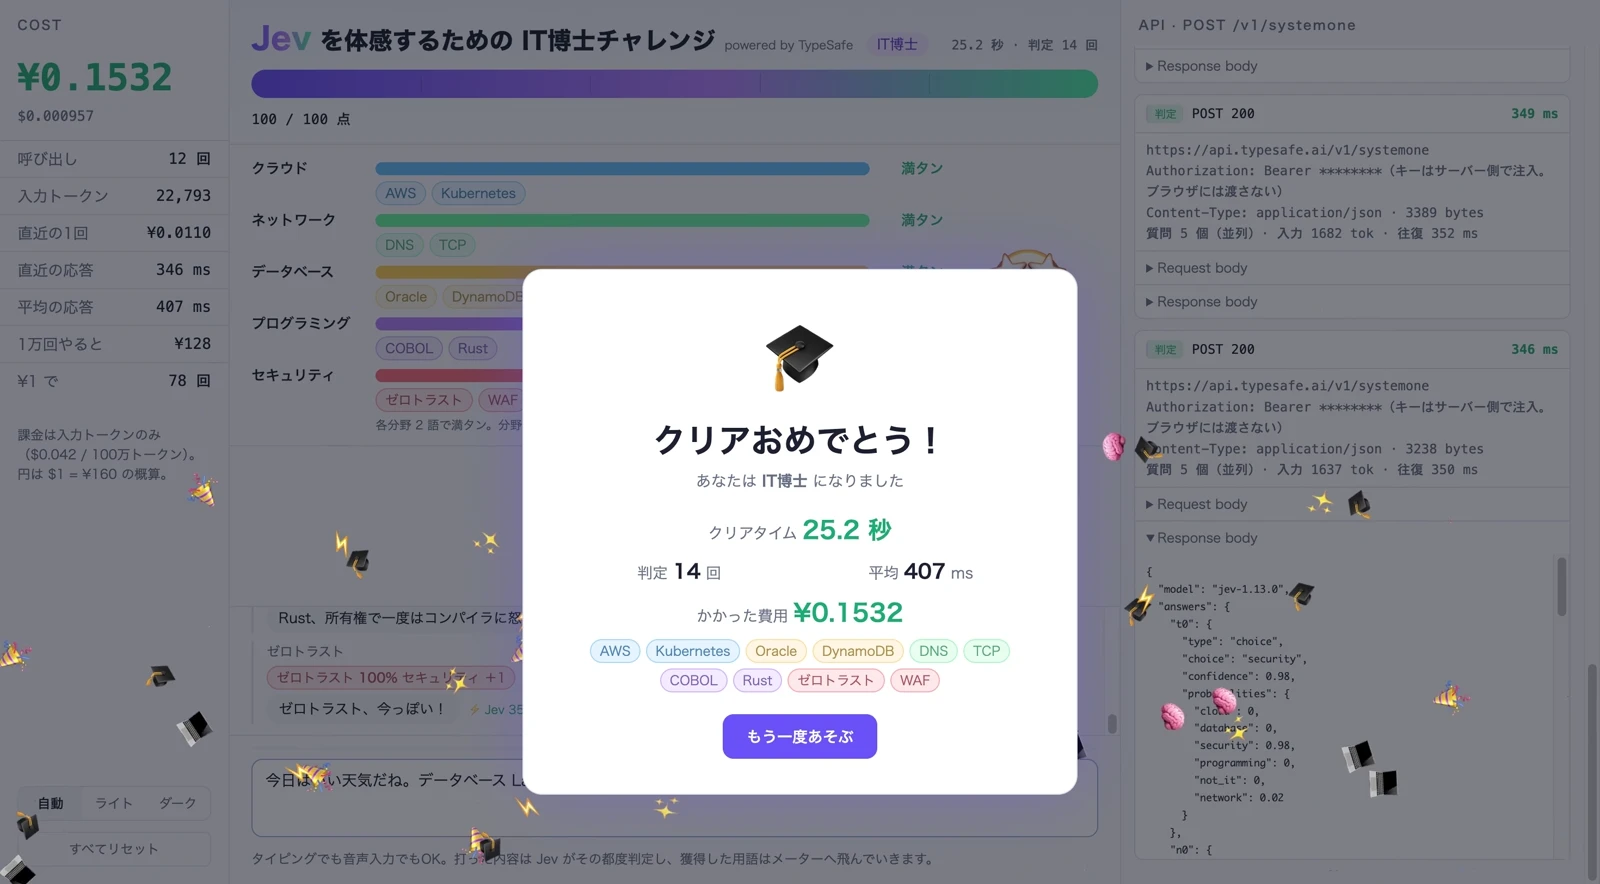
掲載した実走行の結果。約25秒の中には自動入力や演出も含むため、APIそのものの処理速度とは分けて読む。
公式ModelsページのJev 1.13の料金は入力100万トークンあたり$0.042、出力は無料。入力が増えれば費用も増えるが、このゲームでは1回ごとの請求を気にせず質問の作り方を試せる水準だった。[4]
試行錯誤とデモの撮り直しを含む管理画面の合計は、Spend $0.032、Requests 436、Tokens 840,239(約84万)。Spendを同じレートで換算すると¥5.12、約5円だ。これはJev APIの利用分で、Claude Codeの利用料金や人間の作業時間を含む開発費総額ではない。
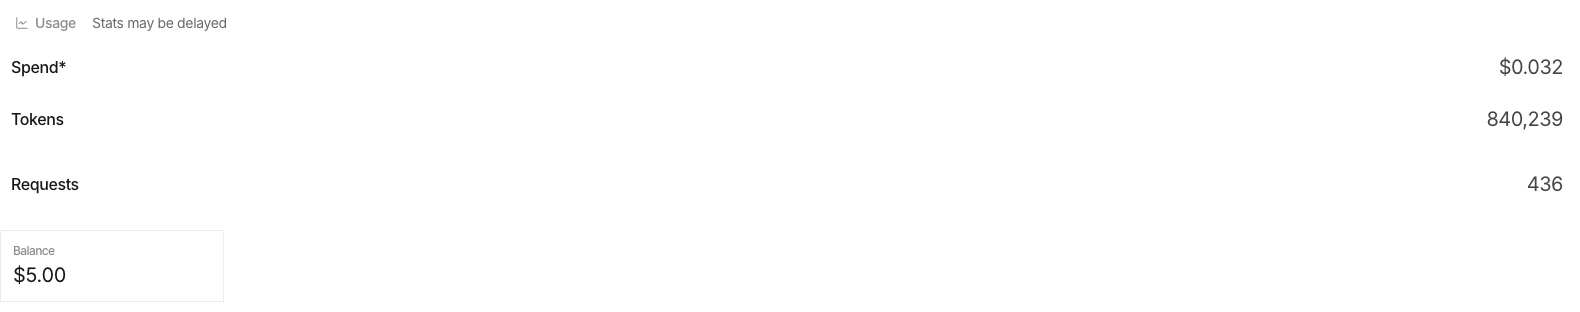
管理画面から合計値とBalanceの領域を切り出して縦に並べた。値は改変していない。「Stats may be delayed」の注意書きも残している。
Balanceは$5.00のままだった。ただ、画面には統計の反映が遅れる可能性が明記されている。残高が変わらないから無料だったとは言えない。Tokensも管理画面の総数なので、入力だけの数と決めつけてSpendを逆算しないことにした。
6. 失敗したところに、使い分けのヒントがあった
一番勉強になったのは、気持ちよく動いた部分より、任せ方を変えた部分だ。
繰り返しの検出はコードへ戻した。 同じ文をそのまま繰り返しても、「繰り返しか」の判定が0.14だった。公式の既知の弱点には、間接参照や複数段階の判断の難しさが挙がっている。この結果だけで原因を特定はできないが、そもそも文字一致や獲得済みの語の確認はコードで確実にできる。そこをモデルに頼む理由はなかった。[5]
「ITではない」の境界を書いた。 分野を選ばせると、一般語の「管理」が94%でIT用語扱いになった。「IT用語ではない」側に管理・設定・モデルなどの例を足すと40%へ下がった。ITの話に登場する語と、IT専門用語は違う。その境界を質問の側で具体化する必要があった。
関連性と名前の一致を分けた。 「DynamoDB」が豆知識の「AWS」に当たった。関係はあるが、AWS用の一言を出したい場面ではない。「その技術の名前そのものか」と問い直し、個別サービスは除く条件を足した。
質問を増やしても、今回の範囲では待ち時間があまり変わらなかった。 1問から5問へ増やした試行では、おおむね350〜490ms。ただし、ときには数秒の遅延もあった。「常に400ms」という保証ではないし、質問数を無制限に増やせるという意味でもない。
こうした調整結果は、この入力と質問文での観察だ。日本語全般の精度や、別の業務でも同じ閾値が通用する証拠にはならない。実装の指定はjev-latestなので、再検証するなら応答に含まれるモデル版も記録しておきたい。
7. APIを叩くだけでは分からなかったこと
ただAPIを叩くだけではつまらないので、体感できる形にしてみた。すると、安さは「何度も直せる余地」に、速さは「次の言葉を入れたくなる反応」に変わった。さらに、コードに任せる方がいい処理も、失敗を通じて見えてきた。
この実験で面白かったのは、Jevだけでなく、エージェントと話しながら試す形そのものだった。自分でコードを書く手を止めても、方向を決める仕事は残る。何を確かめたくて、どこに違和感があるか。それを伝えることが、この小さなゲームを前へ進めた。
コードと動かし方はGitHubのJev Buzzword Rushにまとめている。個人の実験としての提供で、入力はTypeSafeへ送信され、ローカルにもログが残る。自分で動かす際は公開して差し支えない入力で試してほしい。デモモードも実際のAPIを呼び、キーの持ち主に利用料が発生する。
参考文献・出典
- [1]Jev Buzzword Rush — README・実装。本記事の制作経緯は筆者の体験、実測値はデモ動画・管理画面・READMEの記録による。 ↩
- [2]TypeSafe — Primitives (Questions)。Noul・Choice・Scoreの型と回答。 ↩
- [3]TypeSafe — Speculative fan-out。同じstateに対する複数質問の並列評価。 ↩
- [4]TypeSafe — Models。Jev 1.13の入力料金、出力無料、モデルエイリアスの仕様。 ↩
- [5]TypeSafe — Jev 1.13 jaggedness。間接参照、比較・計算、質問の具体化に関する既知の弱点。 ↩
NEW NOVEL 2026/08/01
曇りグラス
磨くってのは、力じゃない。
『世界が少し遠くなった』第二巻。前作の一年後を描く、ここからでも読める五つの短編です。
Amazonで読む
自叙伝ドットコム
あなたの人生は書く価値がある。
AIにだから語れる、本当の自分がある。記憶の断片を拾い集め、ひとつの物語へ。
覗いてみる関連記事
自宅PCが、外出先のAIエージェント端末になる
Claude Code Remote Control と Codex モバイル対応を手がかりに、自宅PCの開発環境を外出先からAIエージェント経由で動かす時代の意味、通信構造、セキュリティを整理します。
Claude Opus 4.7は4.6から何が変わったのか
Claude Opus 4.7が4.6からどう変わったのかを、コーディング、エージェント性能、視覚理解、指示追従、コスト、GPT-5.5との比較まで整理します。
Orcaはなぜ8万スターを集めたのか──好きなAIエージェントのまま、並行する仕事を見渡せる開発環境【AI開発環境】
81.6k starsのOrcaを、CLIを束ねる意味、worktree、差分レビュー、Design Mode、画面の限界から分析。Codex、Claude Code、Google Antigravity、Cursor、Devinと比較し、開発者と無料の事業モデルまで確かめる。
nagaraを作った──AIの返事も小説も、好きな声で「ながら聞き」する【開発記】
Claude Codeの長い返事を、もっと心地よく聴きたかった。AivisSpeechとSwiftで作ったmacOS用OSSプレイヤーnagaraの開発記。静かな受信、文単位の再生、声を変えずに速度を変える設計を紹介する。
Claude Desktopを捨てなくていい。それでもCLIを選ぶ理由──SubagentsとAgent Teams実践ガイド
DesktopのCodeタブでもSubagentsは動く。それでもCLIにしかないAgent Teams、パイプ、シェル環境の直結は何を変えるのか。個人向けClaude契約で使うClaude Codeを前提に、teammateとSubagentが継承する推論モデルとeffort、設定ファイル、Git除外、コピペ可能なレビュー・ログ監視エージェントまで実務目線で解説する。